Un ingeniero de mantenimiento necesita identificar qué equipos registran más fallas. Un responsable de producción quiere calcular el rendimiento promedio por turno. En ambos casos, los datos pueden estar almacenados en una base de datos, pero su utilidad depende de formular las consultas adecuadas.
SQL (Structured Query Language) permite consultar, relacionar, agrupar y analizar información almacenada en bases de datos relacionales. Su aplicación abarca ingeniería industrial, sistemas, logística, manufactura y gestión de activos. Conocer sus instrucciones esenciales ayuda a transformar registros operativos en información útil para evaluar procesos y detectar desviaciones.
Esta guía presenta consultas SQL aplicadas a situaciones de ingeniería, ejemplos prácticos, tablas comparativas y recomendaciones para trabajar con datos de manera segura y ordenada. Los ejemplos utilizan principalmente sintaxis compatible con PostgreSQL.
Qué es SQL y para qué sirve
SQL es un lenguaje declarativo utilizado para interactuar con bases de datos relacionales. En lugar de indicar cada operación interna que debe ejecutar el sistema, el usuario describe qué información necesita obtener o modificar. El motor de base de datos determina cómo procesar esa instrucción.
La documentación oficial de PostgreSQL sobre el lenguaje SQL explica operaciones como consultar tablas, combinar registros, calcular agregaciones y actualizar información. Estas capacidades son especialmente relevantes cuando los datos de ingeniería se distribuyen entre diferentes sistemas.
| Área de ingeniería | Datos utilizados | Aplicación de SQL |
|---|---|---|
| Industrial | Producción, tiempos y costos | Comparar indicadores por línea o turno |
| Mantenimiento | Equipos, fallas y reparaciones | Identificar equipos con mayor frecuencia de fallas |
| Logística | Inventarios y movimientos | Consultar existencias y movimientos |
| Sistemas | Usuarios, aplicaciones y registros | Analizar información y verificar integridad |
Consultas básicas que debes dominar
Las instrucciones SELECT, WHERE, ORDER BY y LIMIT permiten resolver numerosas consultas de análisis operativo. Para los siguientes ejemplos se considera una tabla hipotética llamada produccion, con los campos idregistro, fecha, maquina, unidades y turno.
1. SELECT: seleccionar información. Permite recuperar determinadas columnas sin necesidad de consultar todos los campos.
SELECT maquina, unidades
FROM produccion;
La consulta obtiene la máquina y la cantidad de unidades de cada registro. Es preferible seleccionar las columnas necesarias en lugar de utilizar SELECT * indiscriminadamente, especialmente cuando las tablas contienen muchos campos.
2. WHERE: filtrar registros. Permite recuperar únicamente las filas que cumplen una condición.
SELECT maquina, unidades
FROM produccion
WHERE unidades < 100;
Este filtro identifica registros con menos de 100 unidades. El valor es ilustrativo: para interpretar el resultado como bajo rendimiento, primero debe definirse una meta de producción para cada equipo o turno.
3. ORDER BY y LIMIT: ordenar y seleccionar resultados. Son útiles para revisar los registros más altos o más bajos.
SELECT maquina, unidades
FROM produccion
ORDER BY unidades DESC, id_registro ASC
LIMIT 5;
El resultado contiene cinco registros ordenados principalmente por unidades producidas, de mayor a menor. El identificador establece un orden adicional para resolver empates de manera reproducible. Esta consulta selecciona registros individuales, no necesariamente las cinco máquinas de mayor producción acumulada.
| Instrucción | Función | Uso en ingeniería |
|---|---|---|
| SELECT | Selecciona columnas | Consultar variables de producción |
| WHERE | Filtra filas | Buscar mediciones fuera de un umbral |
| ORDER BY | Ordena resultados | Ordenar equipos por producción |
| LIMIT | Restringe filas devueltas | Revisar los primeros registros de una clasificación |
La sintaxis y el comportamiento de estas cláusulas se encuentran documentados en la referencia oficial de SELECT de PostgreSQL. Algunas instrucciones, como LIMIT, presentan diferencias entre motores de bases de datos.
Cómo agrupar y calcular indicadores
Las funciones COUNT, SUM, AVG, MIN y MAX permiten resumir conjuntos de datos. Combinadas con GROUP BY, ofrecen resultados por máquina, línea de producción, turno o cualquier otra categoría registrada.
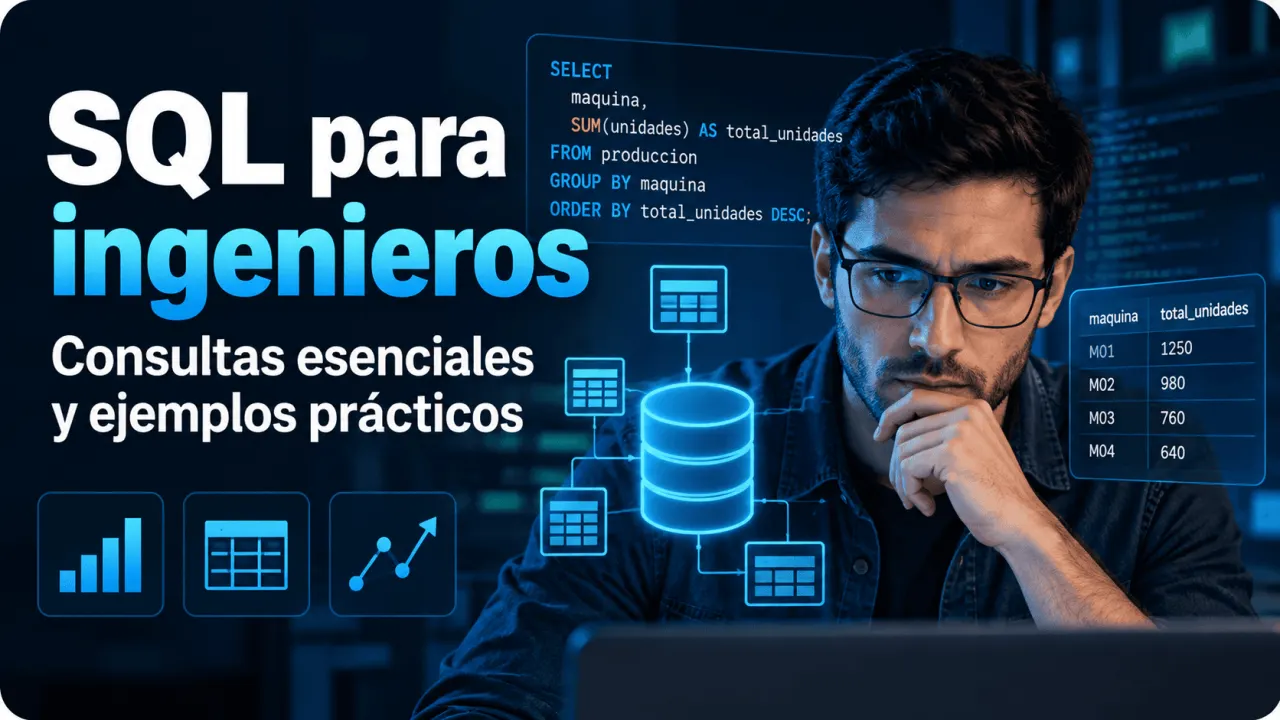
Por ejemplo, para calcular el total de unidades producidas por máquina:
SELECT maquina,
       SUM(unidades) AS total_unidades
FROM produccion
GROUP BY maquina
ORDER BY total unidades DESC;
Esta consulta agrupa los registros de cada máquina y suma sus unidades. Para comparar desempeño entre equipos, conviene incorporar un periodo común y considerar sus horas de funcionamiento, porque una producción acumulada mayor puede deberse a más tiempo operativo.
Cuando se necesita filtrar un resultado agregado, se utiliza HAVING:
SELECT maquina,
       SUM(unidades) AS total unidades
FROM produccion
GROUP BY maquina
HAVING SUM(unidades) > 1000;| Criterio | WHERE | HAVING |
|---|---|---|
| Momento lógico | Antes de agrupar | Después de agrupar |
| Objeto del filtro | Registros individuales | Grupos y agregaciones |
| Ejemplo | Registros con menos de 100 unidades | Máquinas con más de 1000 unidades acumuladas |
JOIN: relacionar diferentes tablas
En una base de datos de mantenimiento, la información de los equipos puede almacenarse en una tabla y sus eventos de falla en otra. JOIN permite combinar ambas mediante una clave compartida, como idequipo.
SELECT e.nombre,
       COUNT(f.idfalla) AS total fallas
FROM equipos e
LEFT JOIN fallas f
  ON e.idequipo = f.idequipo
GROUP BY e.idequipo, e.nombre
ORDER BY total fallas DESC;
El resultado muestra cada equipo y su número de fallas registradas. Se utiliza LEFT JOIN para conservar equipos sin fallas asociadas, cuyo conteo será cero. Este análisis requiere que idfalla identifique cada evento y que los registros estén completos.
| Tipo de JOIN | Registros que conserva | Ejemplo práctico |
|---|---|---|
| INNER JOIN | Coincidencias de ambas tablas | Equipos que tienen fallas registradas |
| LEFT JOIN | Todas las filas de la tabla izquierda y sus coincidencias | Todos los equipos, tengan fallas o no |
| RIGHT JOIN | Todas las filas de la tabla derecha y sus coincidencias | Todos los eventos registrados en la tabla derecha |
| FULL OUTER JOIN | Filas coincidentes y no coincidentes de ambas tablas | Detectar equipos o fallas sin relación asociada |
La documentación oficial de PostgreSQL sobre JOIN desarrolla estas relaciones. Es importante comprobar la cardinalidad: una unión entre tablas con múltiples coincidencias puede multiplicar filas y alterar totales si no se controla el nivel de detalle.
Consultas para análisis más avanzados
Cuando las consultas deben realizar varios cálculos, las expresiones de tabla comunes (CTE) y las funciones de ventana ayudan a organizar el análisis sin perder información de cada registro.
Una CTE definida con WITH puede separar el cálculo de producción por turno de la consulta principal:
WITH resumen AS (
  SELECT turno,
         SUM(unidades) AS total
  FROM produccion
  GROUP BY turno
)
SELECT turno, total
FROM resumen
ORDER BY total DESC;
El resultado permite comparar la producción acumulada entre turnos. Según la documentación de SQLite sobre la cláusula WITH, estas expresiones permiten estructurar subconsultas dentro de una instrucción SQL.
Por otra parte, una función de ventana puede calcular el promedio por turno y mantener visibles los registros individuales:
SELECT maquina,
       turno,
       unidades,
       AVG(unidades) OVER (
         PARTITION BY turno
       ) AS promedio turno
FROM produccion;
A diferencia de GROUP BY, el uso de AVG con OVER conserva cada fila y añade el promedio calculado para los registros de su turno. La guía oficial de funciones de ventana de PostgreSQL describe esta diferencia.
Errores frecuentes y rendimiento
Una consulta puede ejecutarse sin errores y, aun así, producir información equivocada. Esto ocurre cuando se relacionan campos incorrectos, se agregan registros duplicados o se comparan periodos que no son equivalentes.
| Error habitual | Consecuencia | Práctica recomendada |
|---|---|---|
| Usar SELECT * sin necesidad | Recuperación de datos innecesarios | Seleccionar campos relevantes |
| Omitir condiciones JOIN | Combinaciones excesivas de filas | Verificar claves y relaciones |
| Ignorar valores NULL | Interpretaciones incompletas de los datos | Comprobar ausencias con IS NULL |
| Ejecutar modificaciones sin filtros | Cambios sobre registros no previstos | Validar condiciones y usar transacciones |
| Ignorar el plan de ejecución | No detectar operaciones costosas | Revisar EXPLAIN e índices |
En PostgreSQL, EXPLAIN permite examinar el plan que propone el optimizador para ejecutar una consulta. Este plan muestra operaciones como búsquedas mediante índices, lecturas secuenciales, uniones y ordenamientos. La documentación oficial sobre EXPLAIN explica cómo interpretar estas operaciones y sus costos estimados.
EXPLAIN
SELECT maquina, unidades
FROM produccion
WHERE maquina = 'M01';
El plan permite revisar cómo se accederá a los registros de la máquina M01. Crear índices no siempre mejora el rendimiento: su utilidad depende de la selectividad, el volumen de datos, las consultas habituales y el costo de mantenerlos durante las escrituras.
Conclusión
Dominar las consultas SQL esenciales permite al ingeniero pasar de revisar registros aislados a construir análisis reproducibles sobre producción, mantenimiento y operaciones. El siguiente paso consiste en trabajar con datos representativos, comprobar la lógica de cada consulta y documentar los criterios utilizados. Así, los resultados pueden interpretarse y verificarse antes de incorporarlos a una decisión técnica.
Respalda la formación técnica que impartes
Si tu organización ya imparte capacitación en SQL o análisis de datos, el Instituto Internacional de Ingeniería (3i) ofrece opciones para respaldar programas y emitir certificados verificables. Puedes evaluar el proceso de incorporación y las alternativas disponibles para tu actividad.
Fuentes consultadas
PostgreSQL Global Development Group. The SQL Language: conceptos, consultas y operaciones relacionales. Documentación de PostgreSQL 18.
PostgreSQL Global Development Group. SELECT: referencia oficial de consultas, filtros y agrupaciones. Documentación de PostgreSQL 18.
PostgreSQL Global Development Group. Joins Between Tables. Documentación de PostgreSQL 18.
SQLite. The WITH Clause: Common Table Expressions. Documentación oficial, actualizada en 2025.
PostgreSQL Global Development Group. Window Functions: cálculos por particiones y registros. Documentación de PostgreSQL 18.
PostgreSQL Global Development Group. Using EXPLAIN: análisis de planes de ejecución. Documentación de PostgreSQL 18.
Instituto Internacional de Ingeniería (3i). Programa Partner: solicitud, respaldo institucional y validación de credenciales. Página institucional consultada en octubre de 2026.